Das Problem
Wer ein zentrales Support-Postfach betreibt, kennt das: harmlose Rückfragen landen neben Tickets, die sofort jemanden brauchen. Ohne systematische Priorisierung entscheidet oft die Reihenfolge im Postfach statt die tatsächliche Dringlichkeit — und ein kritischer Fall wartet im schlimmsten Fall genauso lang wie eine Standardanfrage.
Der automatisierte Ablauf
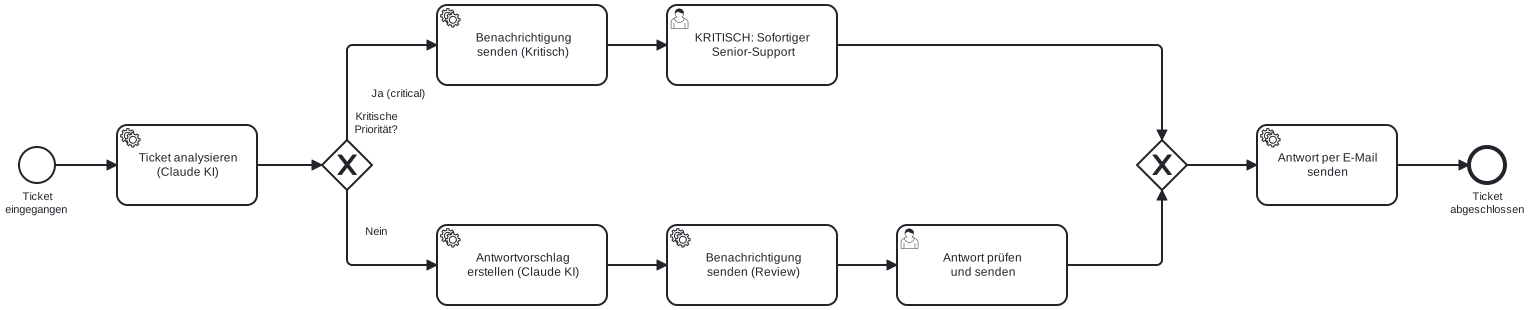
- 01Ticket-Eingang startet den Prozess. Jedes neue Ticket startet eine eigene Prozessinstanz.
- 02Claude analysiert das Ticket. Ein Service Task ruft Claude auf, das Betreff und Text liest und daraus Kategorie und Priorität ableitet — insbesondere, ob es sich um einen kritischen Fall handelt.
- 03XOR-Gateway entscheidet über den Pfad. Die Bedingung
priority = "critical"trennt zwei völlig unterschiedliche Bearbeitungswege. - 04Kritischer Pfad: sofortige Eskalation. Der Senior-Support wird direkt benachrichtigt und übernimmt als Human Task — kein Umweg über einen KI-Entwurf, keine Verzögerung.
- 05Standard-Pfad: KI-Entwurf mit Review. Claude erstellt einen Antwortvorschlag, das zuständige Team wird benachrichtigt und prüft die Antwort als Human Task, bevor sie rausgeht.
- 06Zusammenführung und Versand. Beide Pfade laufen im Gateway wieder zusammen, die Antwort wird per E-Mail verschickt und das Ticket gilt als abgeschlossen.
Warum zwei getrennte Pfade?
Der Reiz liegt in der bewussten Asymmetrie: Ein kritisches Ticket verliert keine Zeit mit einem KI-Entwurf, den ohnehin niemand in Ruhe liest — es geht direkt an einen Menschen. Ein unkritisches Ticket profitiert dagegen vom Zeitgewinn eines KI-Entwurfs, weil hier Sorgfalt vor Geschwindigkeit geht. Diese Unterscheidung lässt sich in einem einzelnen linearen Workflow kaum sauber abbilden — das XOR-Gateway macht sie explizit und nachvollziehbar.
Das echte BPMN-Modell
So sieht der Prozess im Camunda Modeler aus — mit beiden Pfaden, der Gateway-Bedingung und allen Aufgaben im Original.
DSGVO-Einordnung
Der Prozess verarbeitet an zwei Stellen personenbezogene Daten außerhalb des eigenen Systems: wenn Claude das Ticket analysiert (Task_AnalyzeTicket) und wenn Claude den Antwortentwurf erstellt (Task_GenerateResponse). Beides sind faktisch Übermittlungen an einen externen Verarbeiter — das lohnt sich, sauber durchzudenken, bevor der Prozess mit echten Kundendaten läuft:
- Auftragsverarbeitung (Art. 28 DSGVO): Für die kommerzielle API-Nutzung braucht es einen AVV mit dem KI-Anbieter, bevor personenbezogene Daten fließen.
- Drittlandtransfer: US-Anbieter wie Anthropic erfordern eine Rechtsgrundlage für die Übermittlung — Standardvertragsklauseln und/oder eine aktuelle Zertifizierung, im Einzelfall am jeweiligen Vertrag zu prüfen.
- Datenminimierung: Nicht zwingend muss der komplette Ticket-Text raus — wenn für die Klassifizierung z. B. der Absendername nicht gebraucht wird, lässt er sich vorher rausfiltern.
- Speicherung & Training: Klären, wie lange Prompts und Antworten beim Anbieter vorgehalten und ob sie fürs Modelltraining verwendet werden — gehört ins Verarbeitungsverzeichnis (Art. 30).
- Art. 22 DSGVO — hier unkritisch: Der Prozess trifft nie eine vollautomatische Entscheidung, die Kund:innen direkt erreicht. Kritische Tickets gehen an einen Menschen, unkritische durchlaufen einen Human Task, bevor überhaupt etwas verschickt wird.
- Transparenz (Art. 13/14): Sobald echte Kundendaten fließen, gehört der KI-Anbieter als Verarbeiter in die eigene Datenschutzerklärung.
Keine Rechtsberatung — das sind die Punkte, die ich an dieser Stelle prüfen würde, bevor so ein Prozess produktiv mit echten Daten läuft.
Geplante Inhalte
- Formulardefinitionen für die beiden Human Tasks (kritische Eskalation & Review)
- Beispiel-Implementierung der Service-Task-Worker (Claude-Anbindung, E-Mail-Versand)
- Variante mit DMN-Entscheidungstabelle statt fester Gateway-Bedingung